Claude Code、Codex CLI、OpenCode等のAIを使ったコーディングはすっかり一般的になりました。(※なおタイトル画像はAIに作ってもらいましたが、この文章は100%人間が書いています。)
※2026年10月25日更新
一方でAIコーディング活用の壁は大規模言語モデル(LLM)利用のコストでしょう。私の周辺には$100/月や$200/月といったLLMのサブスクリプションにプライベートで加入している人がたくさんいますが、これはかなり例外的で、業務ならともかく趣味のコーディングならせいぜい数千円/月ぐらいで始めたい人も多いのではと思います。
この投稿ではOpenCodeで安価にAIコーディングをはじめる – おすすめ構成($0~$30/月)で紹介したパターンのうち、$10/月、$30/月のパターンを例に、どのように節約する(=トークンの消費を抑える)のが良いかというのを自分の経験(実践)の範囲で説明します。また、格安プランのOpenCode Goについてはこちらに説明記事を書いています。
また、効果的にトークン量を抑えるのは$100,$200プランを利用の方でもメリットがあるかと思います。
費用を抑えるための考え方
費用を抑える方法としては、トークンを無駄に増やさないことと、LLM(モデル)の選択が考えられます。
従量課金のLLM APIサービスではトークン(≒LLMとの間でInput/Outputする情報量)に比例してコストが発生します。これはサブスクリプションでも同じで、多くのトークンを利用すると、5時間・週単位のサブスクリプションの利用制限に到達するのがより早くなります。そのためトークンを無駄に増やさないことは重要です。
ただし、多くの推論プロバイダ(LLMをサービスとしてAPIで提供している企業)ではキャッシュの仕組みがあり、キャッシュヒットした部分は安価に利用できます。つまりトークンが倍になったからといって費用やサブスクリプションの利用量が倍になるわけではありません。一般的にコーディングはキャッシュヒット率が概ね90%以上と言われています(私の経験上も90%以上になっていることが多いです)。
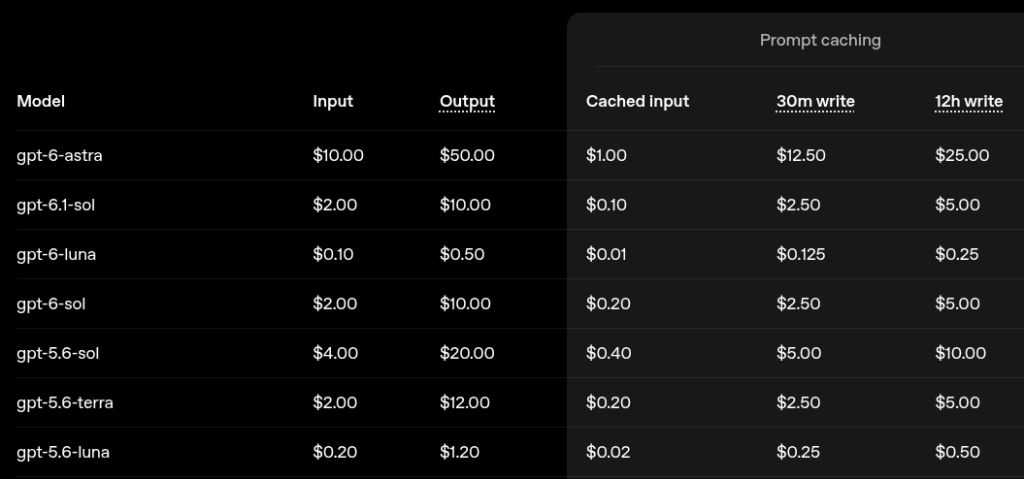
また、モデルの選択も重要です。以下はOpen AIのAPI料金表からの引用ですが、GPT 6.xの中でも、性能が高いastraと、性能は劣るものの安価なluna、その中間のsolといったバリエーションが用意されています。キャッシュヒット(Cached input)時は単価がそれぞれInputの1/10以下になっているのもわかります。
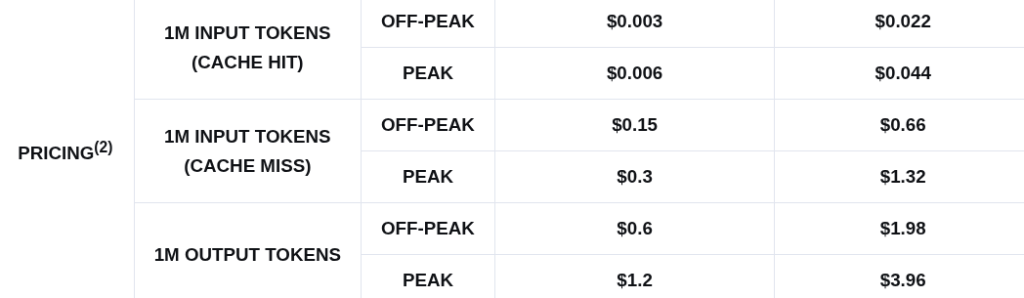
以下は DeepSeek V4 の料金表からの引用です。価格が2つありますが、左がDeep Seek V4.1 Flash (軽量モデル)、右がV4 Pro(高機能モデル)です。OFF-PEAK, PEAKという時間帯による料金の違いがあるものの、全体としてGPTと比較して安価なことが分かります。一般的には著名企業の最先端モデルの費用は高めで、スタートアップは低めです。もちろんモデルの性能が異なるので、安ければ良いという物ではないのですが、節約コーディングにはモデルの選択が重要であることが分かります。
モデル選択の例
多くの方は従量課金ではなく、月額固定のサブスクリプションを選択されると思います。前述の記事で書いたように、$30/月であれば、ChatGPT Plus ($20)+OpenCode Go ($10)、$10で納めるならOpenCode Goが現時点でのお勧めですので、これを例にします。
考え方としては、1/複雑な作業(プラン作成等)、2/メイン(コーディング)作業、3/軽量作業に分けてモデルを選択するのが良いでしょう。つまり基本的には2のモデルを使い、必要なところだけ1を利用、小さい範囲のファイル修正といった軽量作業には3を利用します。
なお本稿の内容からは外れますが、Claude Codeサブスクリプションのみで利用する場合は以下のような感じで考えると良さそうです。
- 複雑な作業(プランニング、深い調査): Opus 5.5 (medium)
- メイン: Sonnet 5.5 (high) をメインにしつつ、場合によっては Opus 5.5 (medium)
- 軽量作業:Haiku 5.5
ChatGPT Plus + OpenCode Goの場合
この組み合わせの場合のお勧めは、以下の通りです。
- 複雑な作業(プランニング、深い調査): GPT-6.1 Sol (high,xhigh) or GPT-6 Luna (high) or Kimi K3.1 Pro
- メイン: GPT-6 Luna (xhigh) or GPT-6.1 Sol (medium) or Kimi K2.7 Code
- 軽量作業: Mimo-V2.6 or DeepSeek v4.1 Flash
GPTをサブスクリプションで利用すると、以下のサブスクリプションプランのレート表に応じてクレジットが消費されます(数字が大きいほど利用可能枠の消費が速い)。これまではGPTのバージョンがあがるごとにAPI単価が上がってきていたのですが、GPT-5.6 LunaはGA後に大きく値下げされ、その後に出たGPT-6.xはSolとLunaもさらに安価になりました。そのため、以前よりも使いやすくなっています。
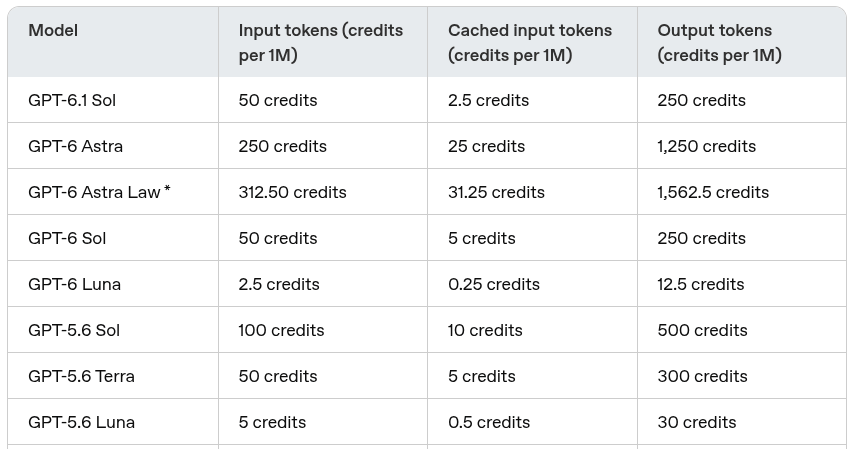
各モデルは性能があがるにつれて無駄な出力をしなくなりますので、上記クレジットの倍率がそのまま消費に反映するわけではありませんが、値下げされたとはいえ$20/月のPlusプランでGPT-6.1 Solを繰り返し使うと、制限に達しやすい印象です。
また、昨今のモデルはThinking Effort(考える量)をユーザーが調整できるようになっており、最低のLowから、最高のMaxまで3~5段階で調整できるようになっているものが多いですが、この調整もコストや時間への影響が大きい印象です。
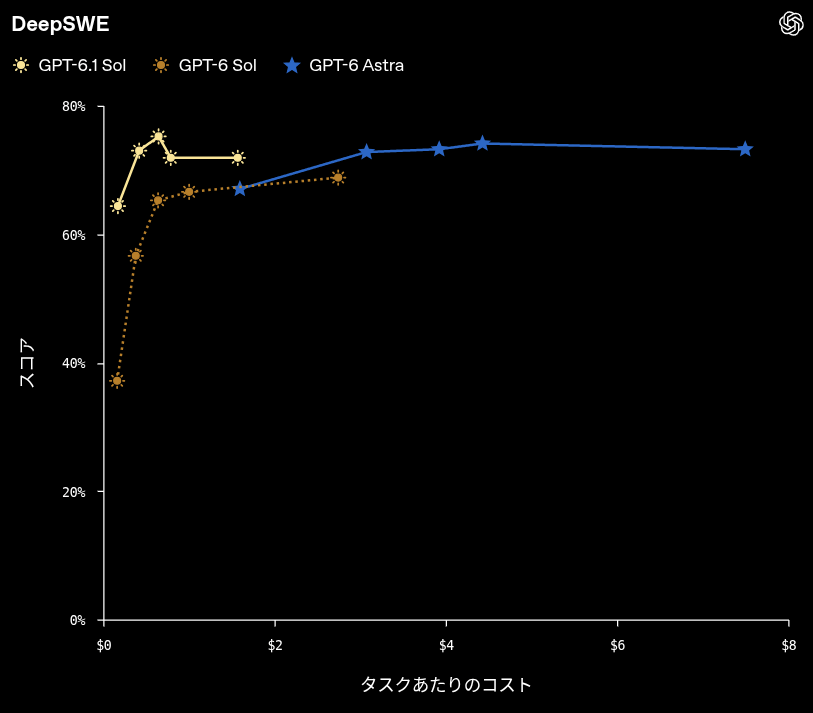
一例ですが、以下のGPT-6.1 SolについてのOpen AIのホームページからの引用によれば、DeepSWEベンチをGPT-6.1 Solで実施した場合(黄色い線)、Highがベストスコアを出しており、それ以上挙げても性能は改善せずコストだけ増えていることが分かります。もちろん用途や内容次第ですが、一般的にはXhighやMaxの設定はコスパが悪くなりがちです。
そこで(1)ではSolのThinking Effortを大きくして(high, xhigh等)、多少コストがかかっても精緻な計画を作り、稼働量の多い(2)では、GPT-6 Luna (xhigh) やGPT-6.1 Sol (medium)を使いつつ、うまくいかない時にGPT以外のモデルに切り替えています。
これは個人の体感でしかないのですが、GPT-6 Lunaは安価なわりにはThinkingを大きくすることで顕著にクオリティがあがる印象で、単価の安さを活かしてxhigh等にするのが効果的に感じています。一方で上図で示された結果と同様にGPT-6.1 Solはmediumもしくはhighが性能と消費トークンのバランスが良い印象です。
このように意識して節約してもGPT Plusプランだと制限にあたる事がしばしばあり、その場合にはOpenCoede Goを利用し、(1)にはKimi K3.1 ProもしくはGLM-5.3を、(2)にはKimi K2.7 Codeを利用しています。OpenCode Goは利用できるモデルが多数あるので選択に悩むところですが、個人的にはKimi K2.7 Codeがコスト・パフォーマンスのバランスに優れていると感じました。コンテキストサイズは256Kで、マルチモーダル対応のため図を読むこともできます。Kimi K3.1 ProとGLM-5.3は極めて性能が高く、コンテキストサイズも1Mあり、プランニングや複雑なデバッグに大変有用なのですが、OpenCode Goの中では高い(クレジット消費が速い)モデルなので、これらを中心的に使用するとすぐにGoの制限に達してしまう点には注意が必要です。
軽量作業(3)には、DeepSeek V4.1 Flashと、MiMo-V2.6が極めて安価でありながら、1Mコンテキストウィンドウ、マルチモーダル(画像認識)対応のため便利です。性能もバージョンが上がるごとに向上している印象です。利用するAIコーディングエージェントにもよりますが、スラッシュコマンド、サブエージェント単位で利用するモデルを指定できる場合は、軽量作業には自動的に安価なモデルを適用しておくと良いでしょう。(OpenCodeでの例についてはこちらに少し書きました)。
なおDeepSeekモデルの注意点として、(執筆時点では)中国でホストされているため、OpenCode Goの管理コンソールで「米国&EU以外」の推論を許可にしないと利用できません。また、ピーク時間帯に利用するとさらに費用が倍になります。詳細はこちらのドキュメントを参照してください。
OpenCode Goだけの場合
$10/月だけで本当にコーディングできるの?と思われるかもしれませんが、割り切って安価なモデルを積極的に使うことで十分にAIコーディングが実現できます。以下はOpenCode Goホームページからの引用ですが、DeepSeek V4.1 Flashの単価の安さと利用量の多さが光ります(バーが長いほどたくさん使える)。
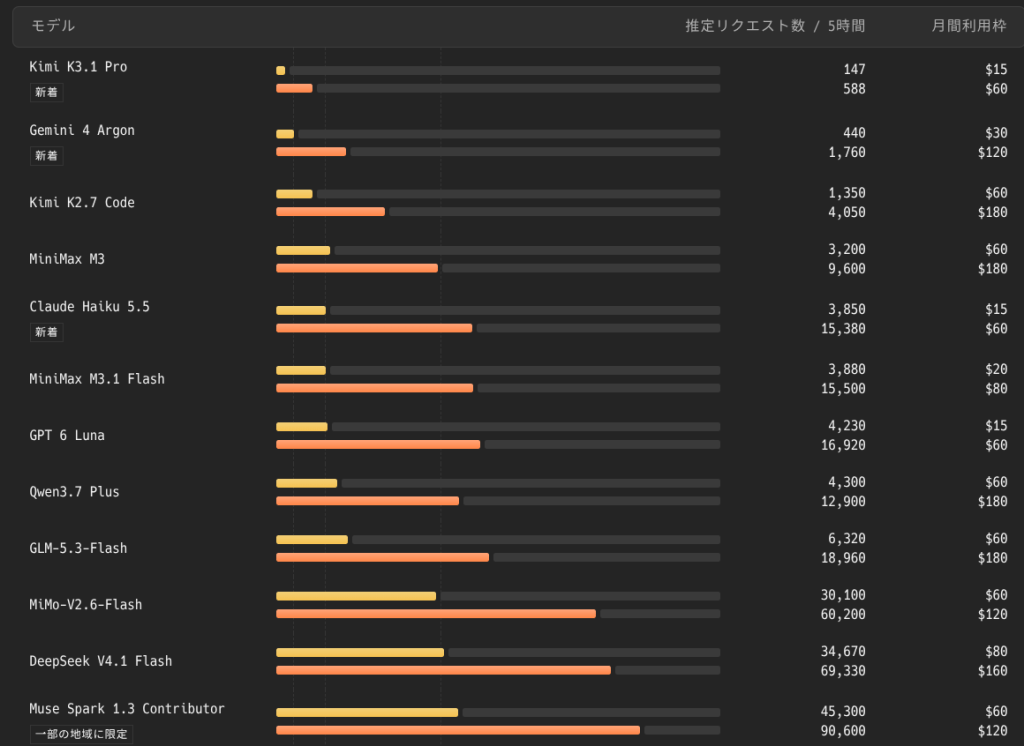
もっと安価なものとして、Muse Spark 1.3 Contributorがありますが、こちらは注意が必要で、このモデルを使う時には自分の入力をモデルの学習に利用することを許可する設定が必要です。これは将来のモデル開発の学習にそのデータをつかうことの対価として、Muse Spark の費用がディスカウントされているためです。また、Muse Spark は、こちらにあるように利用できない地域が設定されているのですが、日本はその制限外のため利用可能です。Muse Spark 1.3は各種ベンチマークで高い成績を出しており、価格に似合わぬ高い性能を備えています。学習に使われてもよい用途であれば、極めてコストパフォーマンスが高いモデルです。
$10/月の場合のお勧めは、以下の通りです。
- 複雑な作業(プランニング、深い調査): GPT 6 Luna (High) or DeepSeek V4.1 Flash (High, Max)
- メイン: DeepSeek V4.1 Flash (High)
- 軽量作業:DeepSeek v4 Flash (Low)
DeepSeek V4.1 Flashは、小型モデルの中では極めて広い範囲の作業がこなせるモデルです。プランだけはしっかりと別モデルで作成し、その後は全部DeepSeek V4.1 Flashに割り振ることでかなりの量のコーディングができます。用途によってはプラン作成もDeepSeek のThinking Effortを高くして実施するのも十分実用的です。DeepSeekでうまくいかないケースではMimo-V2.6-Flashに切り替えるのが良いでしょう。
データが学習に使われるために上記おすすめからは外していますが、利用上問題ないのであれば、1,2,3で全てMuse Spark Contributorを使うのも、とても有効です。
トークンを節約するためのツール
モデルの選択に加えて無駄なトークンを減らすことも重要です。世の中にはトークン(コンテキスト消費)をコンパクトにするためのツールやフレームワークが多数ありますが、個人的に利用していて効果を実感しているツールを紹介します。
CodeGraph
CodeGraph は、AIコーディングエージェントにコードベースの構造を効率よく理解させるためのOSSツールです。ソースコードを解析し、関数の呼び出し関係や依存関係をナレッジグラフとして管理しておくことで、エージェントが大量のファイルをgrepやファイル読み取りで探索する必要なく、必要なコードの位置や変更の影響範囲を把握できるようにします。これにより、コード解析の高速化とトークン消費 を実現できます。開発元のベンチマークでは、ツール呼び出し88%削減、トークン消費62%削減としています。
MCPで提供されているので大抵のコーディングエージェントで利用可能です。またファイルの変更にも自動追従して構造解析する機能があり、これも大変便利です。
以前はcoco-index code (ccc) という、ASTベースのセマンティックコード検索ツールを利用していてこれも大変便利に使っていたのですが、OpenCodeをFirejailという隔離環境の中で動かすようになってから、cccとは相性が悪く(cccがバックグラウンドプロセスを作ってしまうので)、そういったプロセスに依存せずシンプルに使えるCodeGraphに移行しました。ただ、これは私の環境がそうだっただけなので、cccも大変便利でお勧めのツールであることに変わりはないです。
同様に以前はRTKという、ツール呼び出し結果の内容を剪定するツールも併用していたのですが、LLMやハーネスの進化によって私の環境ではだんだん効果がでなくなって来たので、利用を辞めています。
Context7
後で書くSDDにもつながる話ですが、エージェントに無駄な処理をさせないことは、コーディング品質を上げるだけでなく節約の面でも重要です。つまり、適切な参考情報にすぐアクセスできるようにしておくという事ですね。
そういった事を補助するツールも多数あるのですが、Context7は以前からの定番であり、現在でも大変有用なツールです。MCPを設定するだけでエージェントが最新の(OSSの)ドキュメントやAPI仕様を把握し、正確なコードを短時間で出力できるようになります。
MCPを使うとコンテキスト消費が大きいのでは、と思われるかもしれませんが、Context7は2025年末の改善で大幅にコンテキスト消費が抑えられる形にデザイン変更されており、コンテキスト消費をあまり気にせず利用できます。
Spec-driven Development (仕様駆動開発)を適用する
Spec-driven Development (SDD)は、先に仕様(プラン)をしっかり固めたうえで、エージェントにその仕様そって開発させることで、安定した品質のコード生成を行うための手法です。AWSがKiroをリリースした事をきっかけに広く知られるようになり、色々なSDDフレームワーク・ツールが利用可能になっています。
SDDはエージェントとの会話を繰り返して仕様を固めるため、そこでトークンを消費するのですが、その後のコーディングのところではエージェントの迷いが減り、品質向上だけでなく、トータルでのトークン削減につながります。
また、前述の用途に応じたモデル切り替えとも相性が良いです。つまり仕様固め(プランニング)は、高性能なモデル(1)で行い、実際のコーディングやデバッグは(2)や(3)のモデルで行うという方法であれば、モデルを頻繁に切り替える必要もなくなります。
SDDのフレームワークはそれぞれ特徴があるので、好みのものを試してみるのが良いと思いますが、昨今はモデルの進化によりフレームワークを別途用意しなくても、「計画を立てて、内容をレビューしてから実装しましょう」と伝えるだけでも十分SDD風に開発できるようになっています。そのため私もある程度の規模まではフレームワークを使わずに開発することが多くなっています。
一方で、ある程度長期に開発を続ける場合は、仕様の変遷や開発状況を含めて管理できたほうが良いので、規模が大きくなってくるとSDDのフレームワークのメリットが増えてくると感じています。私がこれまで使ったことがあるSDDのフレームワークは以下の2つです。
- OpenSpec : 比較的コンパクトで理解がしやすく、すでに構築が進んでいるプロジェクトに途中から適用することにも柔軟に対応できます。
- cc-sdd: (AWSの)Kiroを意識した形で作られたフレームワークです。やや重めのフレームワークですが、仕様固めの中でしっかりとバウンダリー(どこまで作るか作らないか)を定義し、TDDスタイルでの開発を行う形になっています。
どちらも仕様がファイルとして残り、どこまで対応したか等もファイル上で管理します。そのため、仕様が決まったらいったんセッションを切り替え、新しいセッション(トークン消費していないセッション)で開発をすることができます。
SDDフレームワークの利用の有無に関わらず、エージェントが出力した計画を効率的にレビューしてフィードバックすることの重要性は高まってきており、それについては私はHerdr Annotateというツールを利用しています。それについてはこちらに書きました。
まとめ
想定より長くなってしまいました。現在空前のAIブームということもあり、毎日のように便利なツールが生まれています。上記はあくまで私の経験の範囲でしかないので、ぜひ色々と試してみてください。
個人的には、トークン節約のためにも新しいツールを自分の手法に組み入れていこうと思っていたのですが、実際は逆で、ハーネスやモデル自体の進化により何も入れなくても効率的な作業ができる部分が増え、むしろ周辺ツールやスキル、MCPの利用が減ってきたのが興味深いところです。
引き続き、手法やツール、モデルの変化に合わせて本稿を更新しようと思います。




コメントをどうぞ